🐟 請您尊重本網站的智慧財產權,如有任何引用,請註明出處:Dr. Fish 漫游社會統計。(文章發表日期)。文章名稱。文章網址
獨立樣本t檢定的假設檢定
獨立樣本t檢定(independent samples t-test)是用來探討兩個獨立群組或樣本的平均數是否有顯著不同的一種母數檢定,而獨立樣本t檢定的假設檢定就是在檢驗第1個獨立樣本來自的母群體平均數和第2個獨立樣本來自的母群體平均數相等的虛無假設。
獨立樣本t檢定和獨立樣本z檢定皆是用來比較兩個群組或樣本的平均數是否有顯著不同的統計檢定方法,但獨立樣本z檢定須在兩群組或樣本來自的母群體變異數已知的情況下才可使用。相對地,獨立樣本t檢定則不受此限制,因其直接使用樣本統計量推估母體參數來進行運算,實務上是很常被使用的一種統計檢定方法。
在深入探討獨立樣本t檢定的使用前,建議您先閱讀獨立樣本z檢定的概念和假設檢定的步驟和範例,將有助於文章內容的理解。下面將先回顧樣本平均數差異抽樣分配的概念,再比較獨立樣本t檢定和獨立樣本z檢定、探討獨立樣本t檢定的假設檢定並舉例說明,最後示範利用 SPSS 執行獨立樣本t檢定的操作方式。
樣本平均數差異的抽樣分配
兩個獨立樣本比較的假設檢定會使用樣本平均數差異的抽樣分配(sampling distribution of the difference between sample means),這種抽樣分配是從兩個不同的母群體裡分別隨機抽取出樣本數為  和
 的所有可能樣本,計算出每一個樣本的平均數(
 和
 )後,再計算所有可能配對的樣本平均數差值(
 )以及得到各個差值的機率,而透過該過程所獲得的機率分配就是樣本數為 和 的樣本平均數差異的抽樣分配。
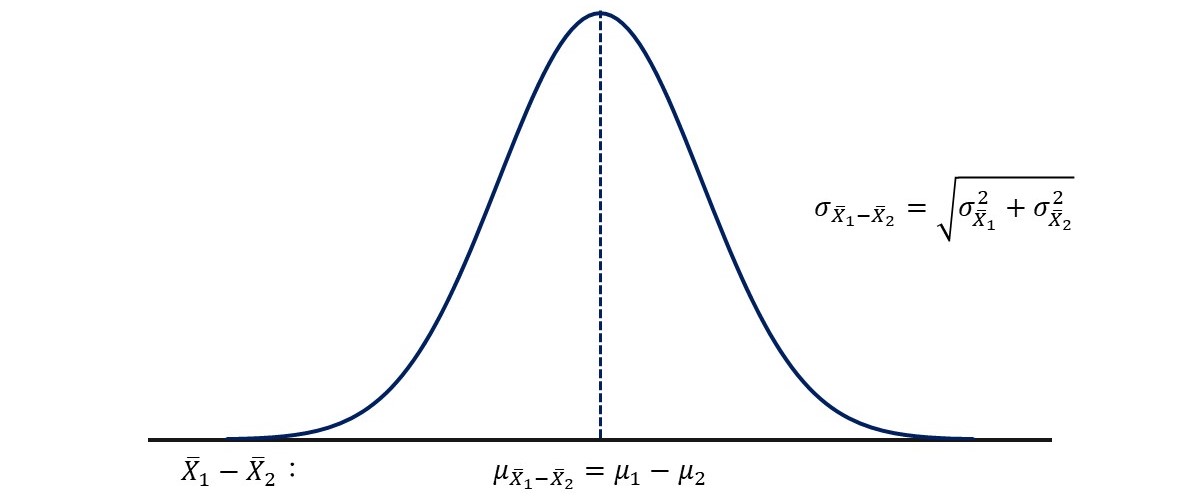
針對不同的樣本數和母群體的分數,重複上面的過程,就可建構出樣本平均數差異的抽樣分配。若樣本來自的母群體呈現常態分配,基本上樣本平均數差異的抽樣分配也會呈現常態分配。此外,這抽樣分配會有一個平均數和一個標準差,分別帶有以下的特徵:
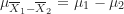 :樣本平均數差異抽樣分配的平均數為兩個母群體平均數的差值。
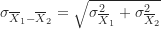 :樣本平均數差異抽樣分配的標準差為樣本數為 的平均數抽樣分配之變異數加上樣本數為 的平均數抽樣分配之變異數後開根號,也稱為樣本平均數差異的標準誤(standard error of the difference between sample means)。
當母群體變異數(標準差的平方)已知的時候,樣本平均數差異抽樣分配為常態分配的型態。此時,若要探討兩個樣本的平均數是否有顯著的不同,可以使用獨立樣本z檢定。讓 、 分別表示第1個和第2個樣本的平均數, 、
 分別為第1個和第2個母群體的平均數,
 、
 分別指第1個和第2個樣本平均數抽樣分配的變異數,z檢定統計量的計算公式如下:
(1) 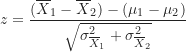
不過大多數的時候,很難知道母群體的變異數,使得獨立樣本z檢定幾乎無用武之地。因此,若要比較兩個樣本平均數是否有顯著差異時,就須改用以樣本統計量來推估母體參數的獨立樣本t檢定。
獨立樣本t檢定和獨立樣本z檢定的比較
在比較一個樣本平均數和一個母群體平均數是否有顯著的不同時,若母群體標準差未知,會使用樣本標準差來估計母群體標準差,也就是用單一樣本t檢定而不是單一樣本z檢定來進行假設檢定。同樣地,當進行兩個樣本平均數的比較且母群體變異數未知時,就須以樣本變異數來推估母群體變異數。
根據變異數總和法則(variance sum law),「兩個獨立的變項之變異等於兩個變項的變異數之和」(Howell, 2009, p. 204)。在獨立樣本的研究設計裡,兩個樣本平均數間彼此獨立,所以樣本平均數差異抽樣分配的變異等於兩樣本各自的平均數抽樣分配的變異數之總和:

接著,回顧平均數抽樣分配的其中一個特性,平均數抽樣分配的標準差等於母群體標準差除以  。套用此特性,再加上變異數是標準差的平方,則上述的樣本平均數差異抽樣分配的變異可再轉換成:

然後,標準誤(標準差)為變異數的平方根,所以樣本平均數差異抽樣分配的標準誤為:

運用相同的邏輯至母群體變異數未知的兩個樣本平均數比較上,利用樣本變異數  來估計母群體變異數
 ,樣本平均數差異的標準誤估計值為:
(2) 
將公式(2)帶入上面公式(1)的分母,即是獨立樣本t檢定的t檢定統計量的公式。比較兩個樣本平均數的z檢定統計量和t檢定統計量的公式如下表:
| 獨立樣本z檢定 | 獨立樣本t檢定 |
|---|---|
|
|
|
|
|
|


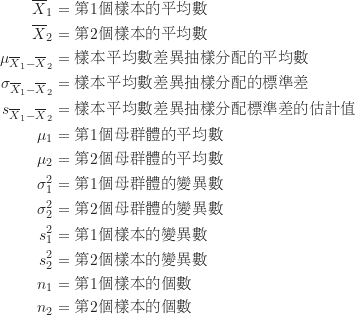
不過公式(2)存在一個問題,當兩個樣本的樣本數不一致的時候( ),該公式就無法提供正確的估計值。為了解決此問題,須改用合併變異數估計值(pooled variance estimate),它考量了樣本的大小並運用自由度(degrees of freedom)加權兩個樣本的變異數。如果將合併變異數估計值簡寫為
 ,則公式為:
(3) 
公式(3)裡, 和
 分別指第1個和第2個樣本的變異數。
 稱為平方和(sum of squares),為離差平方和(sum of squared deviations)的簡稱,為樣本中的每個分數和樣本平均數間的差值平方後相加而得到的數值。另外,
 為自由度,因為每計算一個樣本標準差會失去1個自由度,這裡要計算兩個樣本的標準差,所以會失去2個自由度。
因此,若從變異數未知的第1個母群體中隨機抽取出樣本數為 的樣本,也從變異數未知的第2個母群體中隨機抽取出樣本數為 的樣本,利用公式(3)的 ,下面的公式可提供一個無偏誤的樣本平均數差異標準誤的估計值:
(4) 
最後,再將公式(4)帶入上面公式(1)的分母,就會得到樣本數不一致時可以使用的獨立樣本t檢定的t檢定統計量公式:
(5) 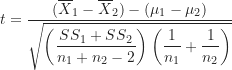
從上面的內容可以知道,當兩個樣本來自的母群體的變異數無法得知時,可以使用t分配來描述樣本平均數差異的抽樣分配,並運用公式(5)來計算t檢定統計量,以便進行獨立樣本t檢定的假設檢定。
獨立樣本t檢定的假設檢定
獨立樣本t檢定用來比較兩個群組或樣本平均數是否有顯著的不同,且在樣本來自的母群體變異數未知的情況下使用。換句話說,這種統計檢定通常是在評估  的虛無假設(
 ),也就是兩個樣本是否來自於兩個相同的母群體平均數的一組隨機樣本。
研究假設須依據研究目的、理論基礎和先前的研究發現來擬定,且可以分為無方向性和有方向性的假設。有方向性的假設須在對立假設( )裡明確地敘述方向,例如第1個樣本平均數大於第2個樣本平均數,也就是說,樣本是來自於母群體平均數
 的隨機樣本。
擬定好研究假設後,須再考量研究的性質、目的與可能帶來的後果,選擇適當的顯著水準或稱為 α 水準,通常為0.05、0.01或更嚴苛的0.001。另外,根據研究假設方向性的有無,決定假設檢定為單尾檢定或雙尾檢定。
獨立樣本t檢定使用t分配和t檢定統計量,而t檢定統計量的公式即為上面的公式(5)。因為在多數的情況下,我們是評估 的虛無假設,也就是  ,所以公式(5)可再簡化成下面的公式:
(6) 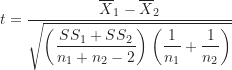
獲得t檢定統計量後,查詢t分配表,自由度為  (
 為兩個樣本個數的總和),依循事先選擇好的 α 水準,找到相對應的臨界值。最後,運用決策規則,比較t檢定統計量和臨界值,此時可區分為雙尾檢定和單尾檢定兩種情況:
- 雙尾檢定:在對立假設裡沒有指出兩個樣本平均數的差異方向,當t檢定統計量的絕對值等於或大於臨界值的絕對值時,可以拒絕虛無假設,並接受對立假設。
- 單尾檢定:在對立假設裡指出兩個樣本平均數的差異方向,須先確認t檢定統計量的符號是否和對立假設陳述的方向一致,若不一致,直接保留虛無假設,無須再比較統計量和臨界值。若兩者的方向一致,當t檢定統計量的絕對值等於或大於臨界值的絕對值時,可拒絕虛無假設。例如對立假設為第1個樣本的平均數小於第2個樣本的平均數,計算出來的t檢定統計量應為負數(
 ),才須進一步比較t檢定統計量和臨界值。
此外,如果使用統計分析軟體(例如 SPSS)來執行獨立樣本t檢定,通常會輸出獲得特定t檢定統計量的機率( 值)而不是臨界值。這時須運用機率比較的決策規則,當 值小於或等於 α 水準時(
 ),可以拒絕虛無假設,接受對立假設;反之,則保留虛無假設。
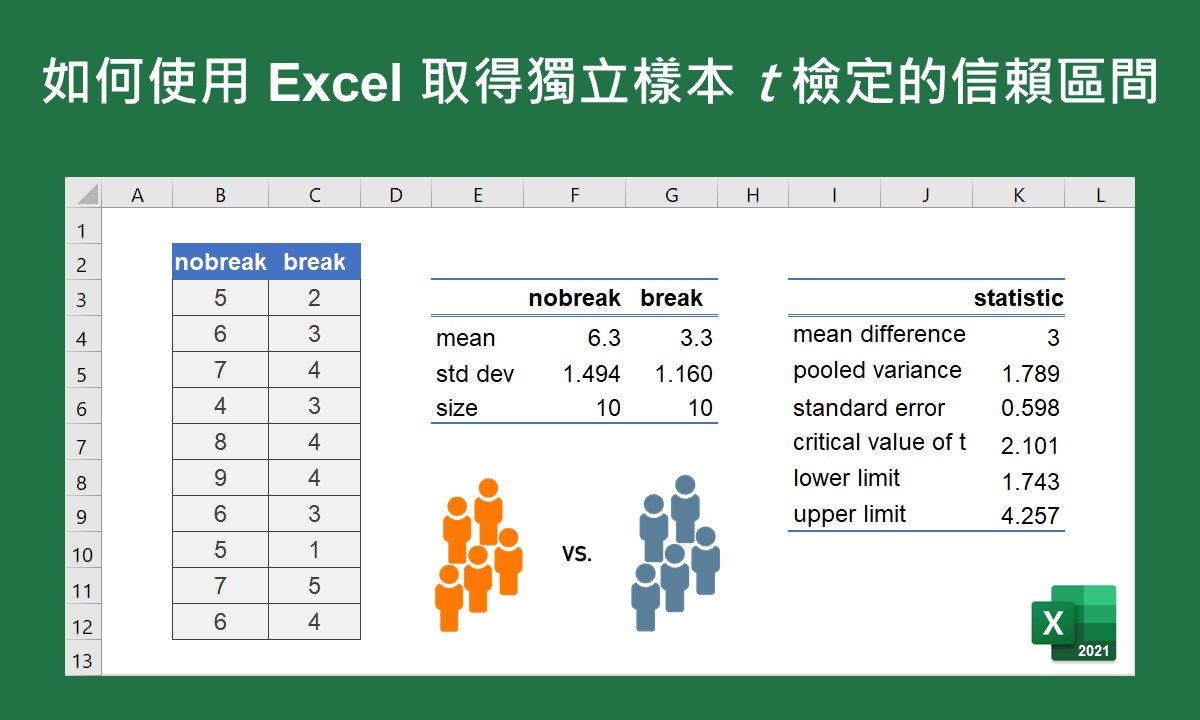
除了這裡描述的假設檢定過程外,也可以透過信賴區間建構的方式來評估自變項是否真實地存在效果。信賴區間的建構不但能夠檢驗2個獨立樣本平均數是否有顯著的不同,也可用來瞭解樣本來自的母群體平均數差異可能存在的數值範圍。當結果指出樣本平均數確實不同,也就是自變項具有效果時,可再利用效果量來探討效果的大小。關於這2種統計量的詳細說明,可以參考獨立樣本t檢定的信賴區間和效果量。
獨立樣本t檢定的基本假設
獨立樣本t檢定是個很受歡迎且很常被使用的統計檢定方法,是一種對樣本來自的母群體做出特定假設的母數檢定(parametric test)。當利用獨立樣本t檢定進行假設檢定時,樣本資料須滿足下面的兩個假設:
- 常態分配:樣本平均數差異()的抽樣分配須呈現常態分配,這也是指樣本來自的母群體必須是常態分配的型態。
- 變異數同質性(homogeneity of variance):兩個樣本來自的母群體的變異是相同的,也就是
 的情況。如果兩個樣本一開始就存在很大的變異,很有可能不是來自於母群體 的隨機樣本,即是違反了該假設。
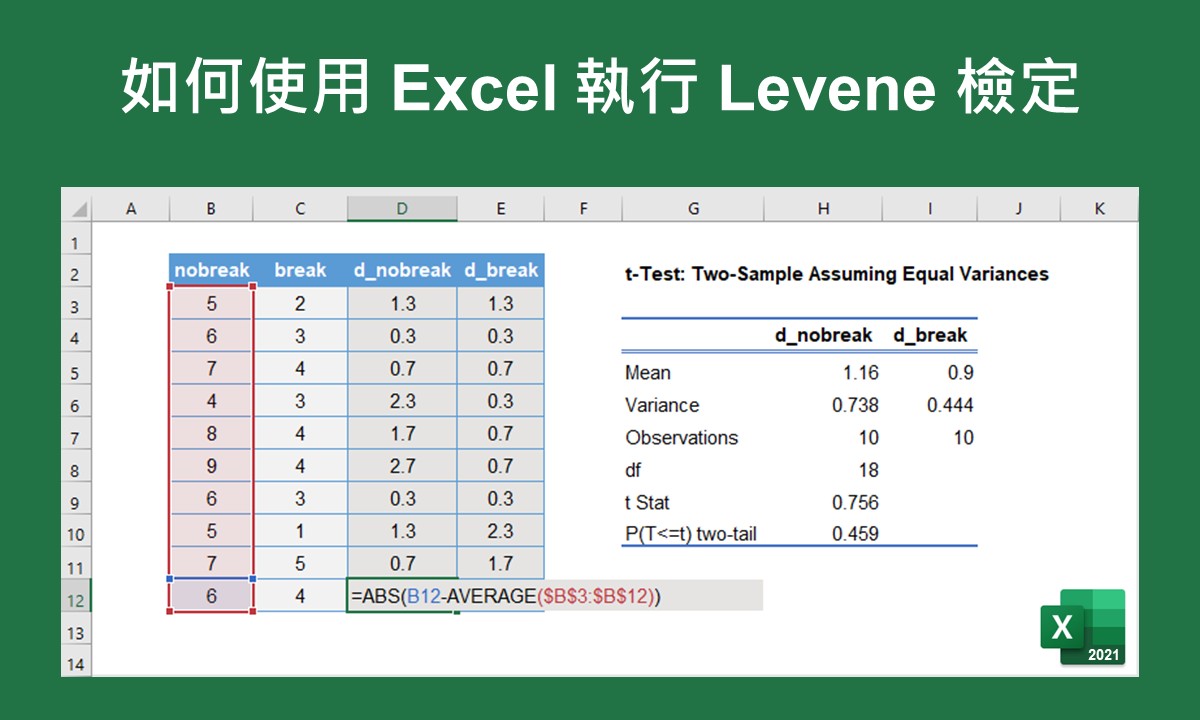
變異數同質性假設的檢驗通常會使用 Levene 檢定(Levene′s test),而且這個檢定為大多數統計分析軟體的預設檢定方法。若您想進一步瞭解 Levene 檢定的概念和計算原理,請參考 Levene 檢定:檢驗樣本間變異數是否相等的方法。
雖然執行獨立樣本t檢定時,樣本資料最好能夠滿足上述的兩個假設,但獨立樣本t檢定可說是一種穩健(robust)的統計檢定,即使違反了假設,該檢定的執行結果仍會如預期(Sawilosky & Blair, 1992)。更正確地說,如果兩個樣本的樣本數一致( )、每一個樣本的樣本數等於或大於25且使用雙尾檢定時,即使輕度或中度違反假設,檢定的結果仍具有可信度。
然而,若兩個樣本的樣本數不一樣,解釋研究結果時就要特別小心。如果兩個樣本的樣本數差異很大或變異很大,獨立樣本t檢定可能就不是一個合適的統計檢定方法,此時可考慮其他的統計檢定方法,例如調整不相等變異的 Welch t 檢定(Welch′s t-test),或無母數檢定裡的曼–惠特尼U檢定(Mann-Whitney U test)。
瞭解了獨立樣本t檢定的假設檢定過程和資料須滿足的基本假設後,下面舉一個例子來實際操作獨立樣本t檢定。
獨立樣本t檢定的假設檢定之範例
假設有一位工廠老闆想探討工作時安排一個休息時間是否會影響員工的工作失誤次數,他將20位員工分成兩組,一組和原先的工作模式相同,工作過程中沒有任何休息(nobreak);另一組則可以在下午2:45到3:00之間休息(break)。該位工廠老闆紀錄了這20位員工在下午3:00到5:30間的工作失誤次數,如下表。使用獨立樣本t檢定,α 水準為0.05、雙尾檢定,試問工作中的休息時間是否影響了工作失誤的次數?
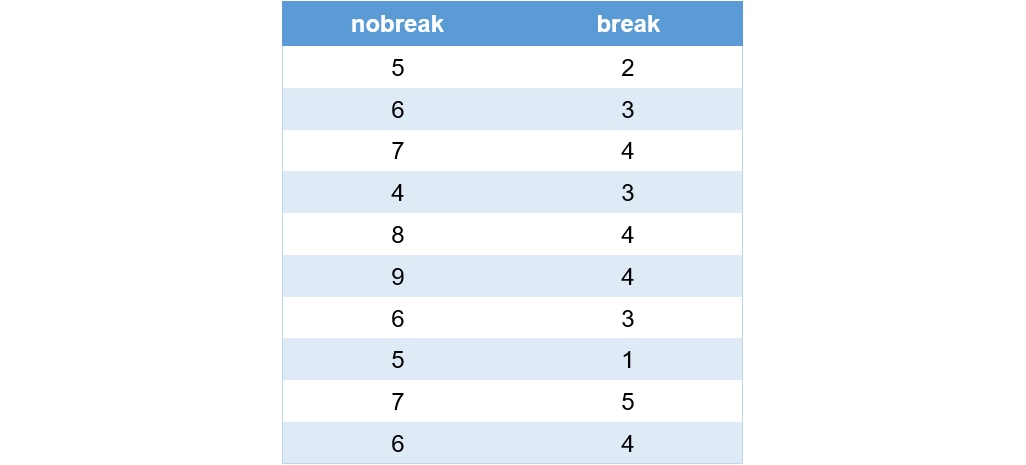
這位工廠老闆想瞭解工作中的休息時間是否會「影響」員工的工作失誤次數,所以是沒有方向性的研究假設。對立假設和虛無假設分別如下:
- 對立假設():沒有休息的員工和有休息的員工在工作上的失誤次數有所不同,也就是他們是來自於母群體
 的隨機樣本。
- 虛無假設():沒有休息的員工和有休息的員工在工作上的失誤次數沒有不同,也就是他們是來自於母群體
 的隨機樣本。
因為工廠老闆想比較兩組工作人員的工作失誤次數是否有顯著的不同,而且不知道母群體的變異數,所以採用獨立樣本t檢定,並選擇0.05的 α 水準。另外,由於研究假設不具有方向性,所以使用雙尾檢定。
接著,運用上面的公式(6)來計算t檢定統計量。因為計算過程需要離差平方和  和
 ,所以先將套用公式時需要的數值在如下的表格裡計算出來:
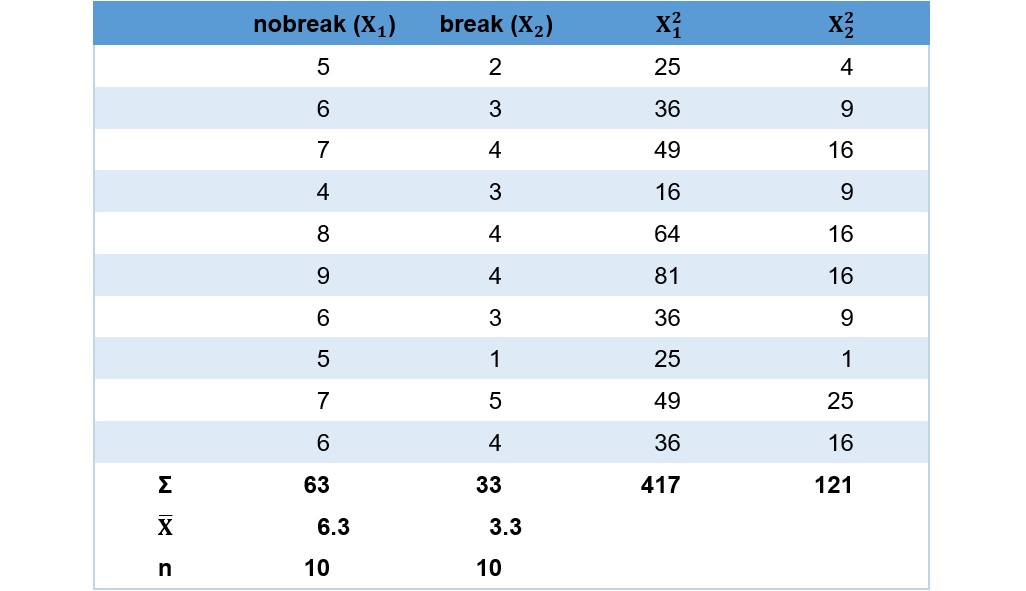
上表中的符號  指所有分數的總和、
 為平均數、
 指樣本的個數。利用表格裡的數值來計算離差平方和 和 ,計算過程如下:

如果您不清楚總和運算的方式,請參考社會統計常用的基本數學符號和運算。上面的計算結果得到 為20.1、 為12.1,再將 和 、兩個樣本的平均數和個數帶入公式(6)。若把計算過程中無法整除的數值四捨五入到小數點後第5位,最後的結果則四捨五入到小數點後第3位,計算過程如下:

計算結果顯示t檢定統計量為5.016,然後查詢t分配表,當  、
 、雙尾檢定時,t臨界值為
 。
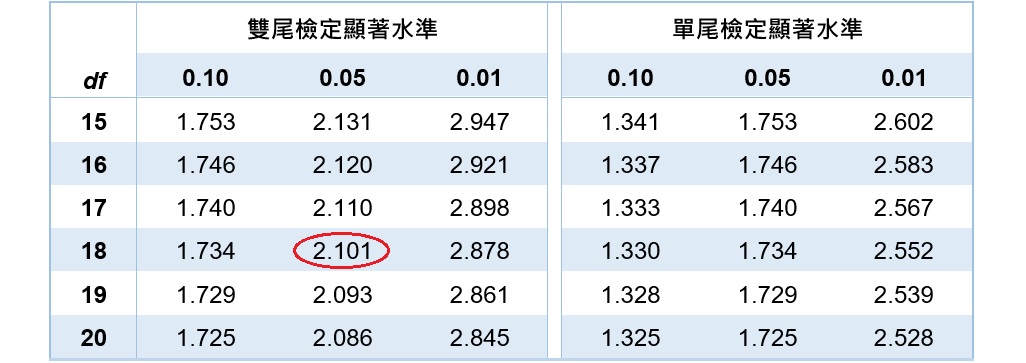
最後,運用檢定統計量和臨界值比較的決策規則,因為  ,所以拒絕虛無假設,接受對立假設。分析結果顯示,沒有休息的員工和有休息的員工在工作失誤次數上有明顯的不同,從兩組的平均數來看,有休息的員工在工作失誤次數上少於沒有休息的員工。
運用 SPSS 執行獨立樣本t檢定
將上面範例的資料輸入至 SPSS 資料編輯器裡,因為有20個人,所以會有20筆資料,變項 ID 為員工的編號。除了工作失誤次數的變項 MISTAKE 之外,還要增加一個組別 GROUP 的變項,標籤值1代表沒有休息,標籤值2代表有休息,如下圖所示。關於 SPSS 資料輸入的方法,請參考 SPSS操作環境和資料輸入。
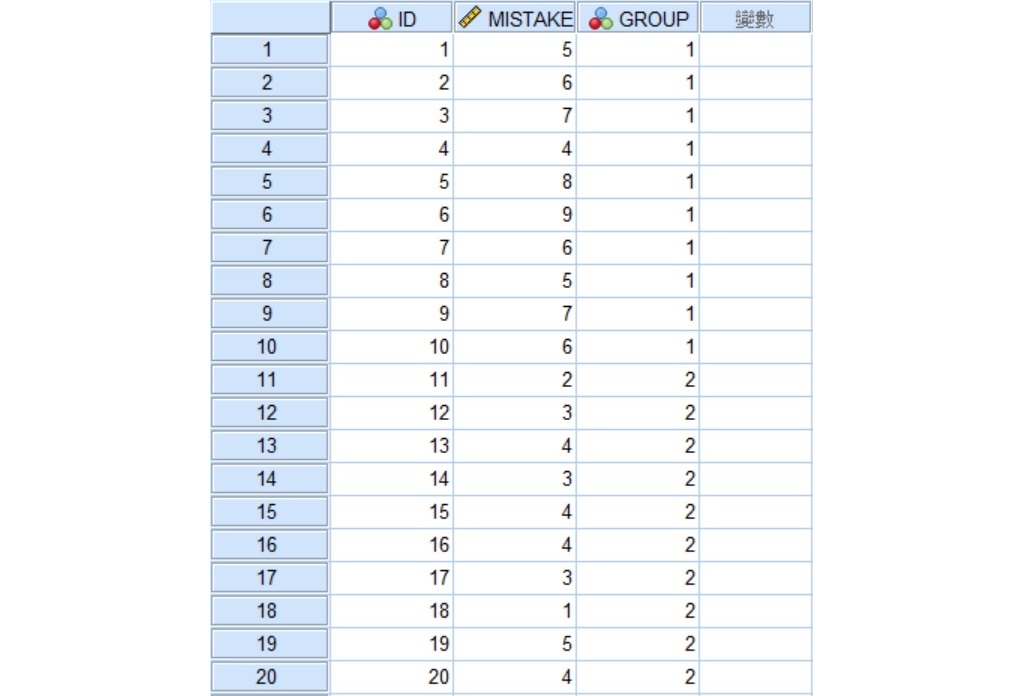
資料輸入完成後,點選功能表的分析 » 比較平均數 » 獨立樣本T檢定,帶出「獨立樣本T檢定」的視窗。
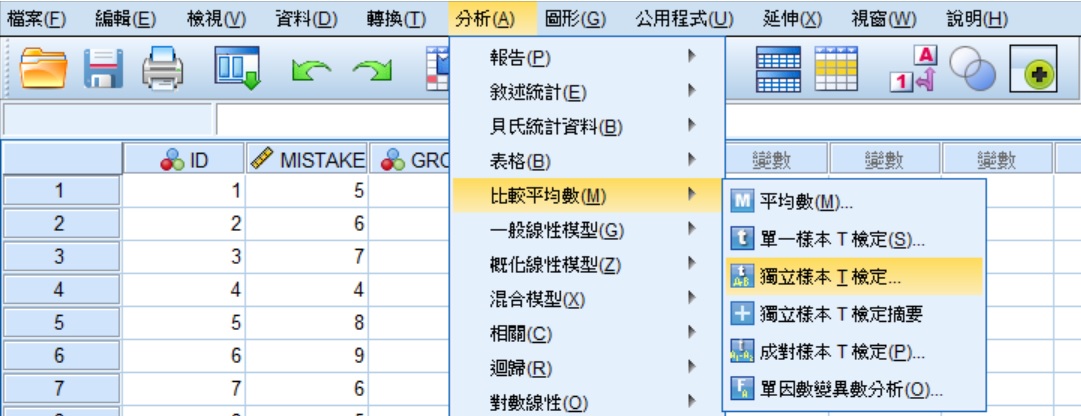
在「獨立樣本T檢定」的視窗中,將 MISTAKE 從左邊的長方框中移到檢定變數(T)裡,GROUP 則移到分組變數(G)裡。
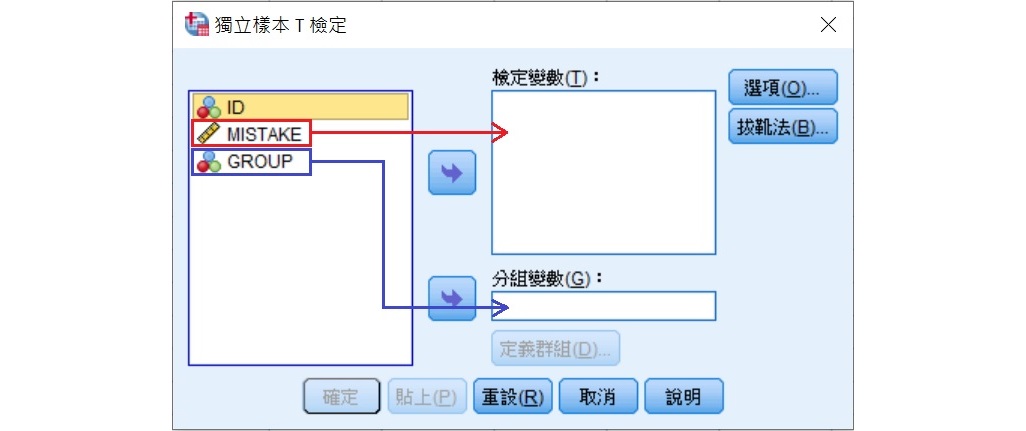
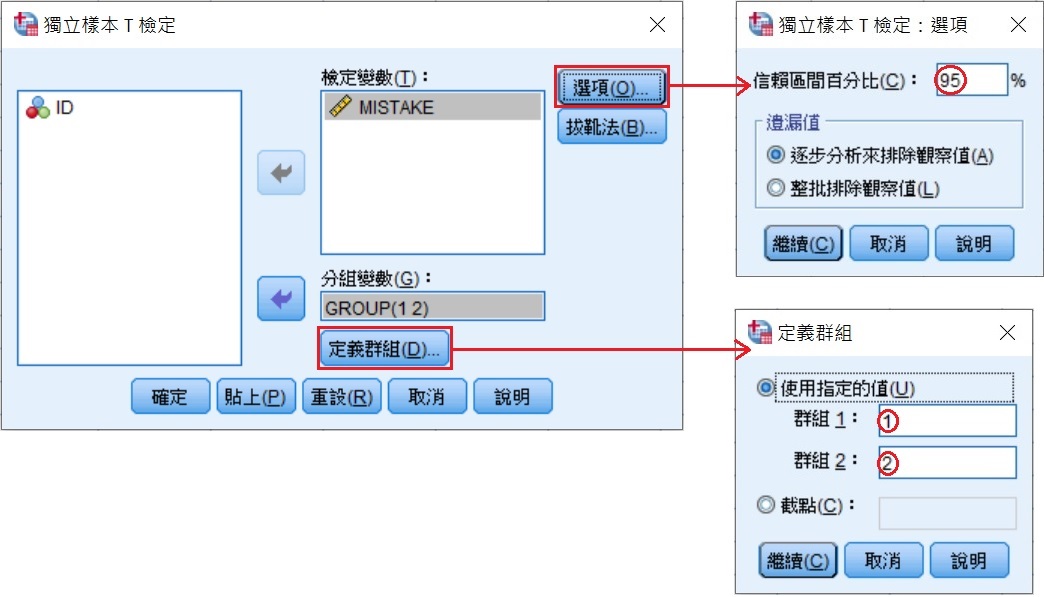
將 GROUP 移到分組變數(G)裡後,按一下定義群組(D),在隨即出現的「定義群組」小視窗中,選擇使用指定的值(U)並輸入兩群組在資料輸入時的編碼數值。在這裡的範例,資料輸入時沒有休息組的編碼數值為1、有休息組的編碼數值為2,所以將這兩個數值輸入至群組1和群組2的長方格中,完成後按下繼續(C)。
另外,「獨立樣本T檢定」視窗的最右邊有一個選項(O),按下後會出現「獨立樣本T檢定:選項」小視窗,根據事先選擇好的顯著水準(α 水準),在信賴區間百分比(C)方格裡輸入相對應的數值。若 α 為0.05,在這裡輸入95;若 α 為0.01,則在此輸入99,以此類推。完成後,按下繼續(C),回到上一個視窗後,再按下最下方的確定。
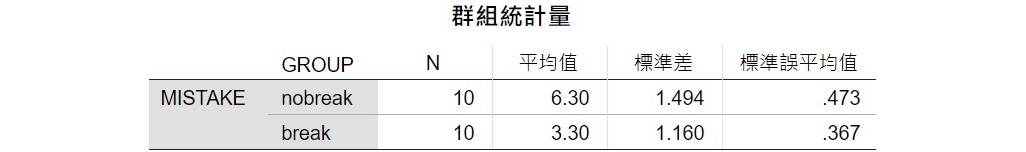
完成上述的步驟後,SPSS 會輸出兩個表格,第1個表格為「群組統計量」表,顯示兩個群組各自的描述統計量。從下表可看出,兩個群組各有10人,沒有休息的組(nobreak)平均工作失誤次數為6.3次,標準差為1.494;有休息的組(break)平均工作失誤次數為3.3次,標準差為1.160。
第2個表格為「獨立樣本檢定」表,顯示獨立樣本t檢定的分析結果。這表格會呈現兩種檢定的結果,一個是「採用相等變異數」,另一個則是「不採用相等變異數」的結果,要使用哪一個結果須視「變異數等式的 Levene 檢定」來決定。
Levene 檢定用來檢驗兩群組的變異數是否相等,也就是樣本資料是否滿足變異數同質性的假設。如同其他統計檢定方法的假設檢定過程,Levene 檢定檢驗兩群組變異數相等的虛無假設,若該檢定的 值小於或等於0.05,代表兩群組的變異不相等;若該檢定的 值大於0.05,則代表兩群組的變異相等。
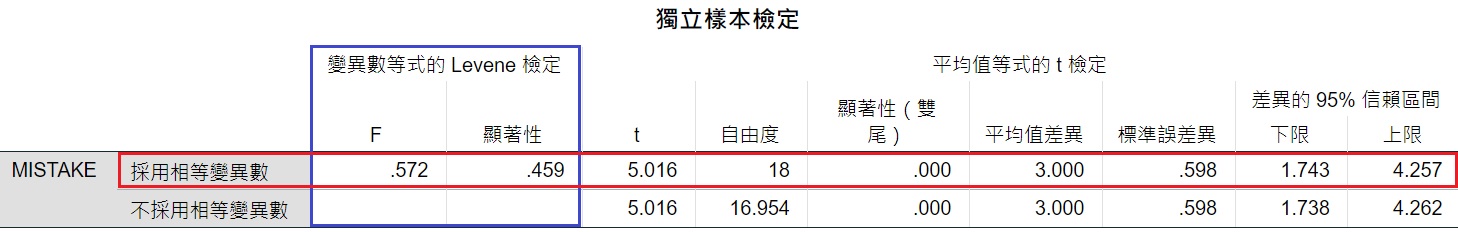
從上表可以看出,Levene 檢定的 值為0.459,因為  ,代表兩群組的變異數相等,所以要看「採用相等變異數」那一列的獨立樣本t檢定的結果。關於更詳細的 Levene 檢定的說明,請參考 Levene 檢定:檢驗樣本間變異數是否相等的方法。
分析結果顯示,t檢定統計量為5.016,自由度為18,雙尾檢定的 值為0.000。利用機率比較的決策規則,因為  ,所以拒絕虛無假設,接受對立假設。這樣的分析結果和上面紙筆計算的結果相同,皆顯示有休息的員工和沒有休息的員工在工作失誤次數上有顯著的不同,再從兩群組的平均數來看,有休息的員工在工作失誤次數上明顯地少於沒有休息的員工。
SPSS 輸出的顯著性結果( 值)為雙尾檢定的機率,若是執行單尾檢定,須將 值除以2後再與 α 水準比較,才可評估是否拒絕虛無假設。
獨立樣本t檢定為兩個「獨立的」樣本或群組比較的一種統計檢定方法,若是樣本或群組之間具有關聯性,例如相同研究參與者的前後測成績之比較、配對受試者對不同治療方法的反應之比較,則須使用關聯樣本t檢定(或稱為成對樣本t檢定),詳細的介紹請參考關聯樣本t檢定的假設檢定。
以上為本篇文章對於獨立樣本t檢定的介紹,希望透過本篇文章,您瞭解了獨立樣本t檢定和獨立樣本z檢定的差異、獨立樣本t檢定的使用時機和假設檢定的過程,也學會了利用 SPSS 執行獨立樣本t檢定的操作方法。若您喜歡本篇文章,請將本網站加入書籤,並持續回訪本網站喔!另外,也歡迎您追蹤本網站的 Facebook 和/或 X(Twitter)專頁喲!
如果您覺得本篇文章對您有幫助,歡迎買杯珍奶給 Dr. Fish!小小珍奶,大大鼓勵,您的支持將給 Dr. Fish 更多撰寫優質文章的動力喔!
參考資料
Howell, D. C. (2009). Statistical methods for psychology (7th ed.). Belmont, CA: Wadsworth.
Sawilowsky, S. S., & Blair, R. C. (1992). A more realistic look at the robustness and Type II error properties of the t test to departures from population normality. Psychological Bulletin, 111(2), 352-360. https://doi.org/10.1037/0033-2909.111.2.352